Belangrijkste punten van de redactie
- Voor lokale AI en machine learning is het videogeheugen van de GPU de belangrijkste specificatie: richt je op minimaal 24 GB VRAM als je moderne taalmodellen wilt draaien.
- CUDA blijft in 2026 de onbetwiste standaard voor machine learning; een NVIDIA-GPU bespaart je uren aan driver- en compatibiliteitsproblemen ten opzichte van alternatieven.
- Combineer een krachtige GPU met 64 GB of meer werkgeheugen, snelle NVMe-opslag en een voeding met ruim voldoende reservecapaciteit voor een stabiele workstation.
Steeds meer ontwikkelaars en hobbyisten willen AI-modellen lokaal draaien in plaats van dure clouddiensten te gebruiken. Een eigen AI-workstation geeft je volledige controle over je data en op termijn vaak lagere kosten. Maar zo’n machine vraagt om andere prioriteiten dan een gaming-pc: bij machine learning draait het vooral om geheugencapaciteit, tensor-rekenkracht en stabiliteit onder langdurige belasting.
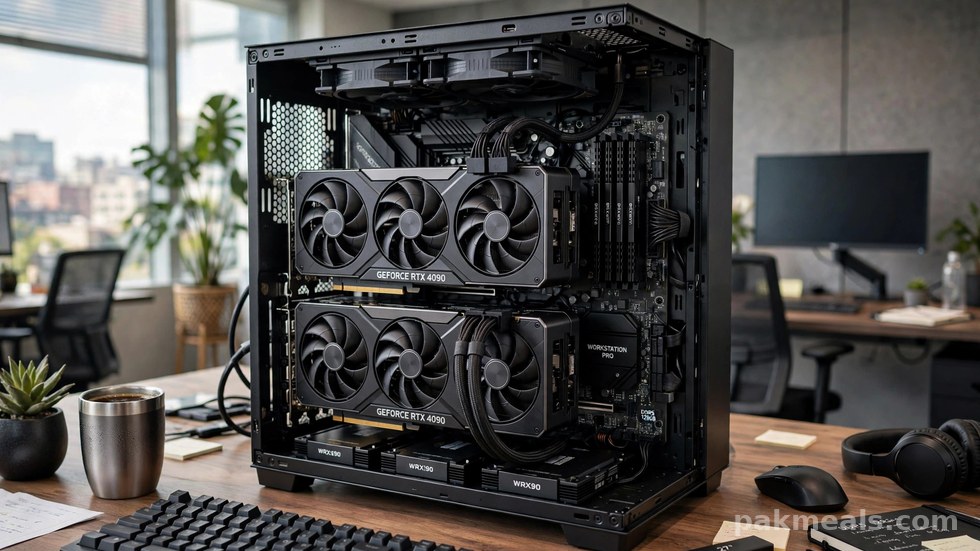
In dit artikel zetten we uiteen welke hardware er echt toe doet voor machine learning in 2026: de GPU en zijn VRAM, de rol van CPU en moederbord, werkgeheugen, opslag en voeding. We sluiten af met drie complete build-voorbeelden in verschillende prijsklassen.
De GPU: het hart van elke AI-workstation
Bij machine learning doet de GPU het overgrote deel van het zware werk. Training en inferentie bestaan uit enorme hoeveelheden matrixvermenigvuldigingen, waarvoor moderne GPU’s met hun duizenden cores en tensor-eenheden precies gebouwd zijn. Een CPU is tientallen tot honderden keren langzamer. De GPU-keuze bepaalt daarom welke modellen je kunt draaien en hoe snel dat gaat.
VRAM: waarom geheugen belangrijker is dan pure snelheid
De meest onderschatte specificatie bij AI-workloads is het videogeheugen. Een taalmodel moet volledig in het VRAM passen; past het niet, dan kun je het simpelweg niet laden, hoe snel je GPU verder ook is. Reken op ongeveer 2 GB VRAM per miljard parameters bij standaard precisie, en ongeveer de helft bij kwantisatie naar 8 of 4 bit.
Voor de praktijk betekent dit dat 24 GB VRAM in 2026 het verstandige minimum is voor serieuze lokale AI. Daarmee draai je comfortabel modellen tot zo’n 30 miljard parameters in gekwantiseerde vorm, plus de populaire beeldgeneratiemodellen. VRAM kun je later niet bijplaatsen, dus koop liever iets te ruim dan te krap.
CUDA tegenover ROCm: de software-ecosysteemkeuze
Hardware is slechts de helft van het verhaal; de software bepaalt of je machine in de praktijk lekker werkt. NVIDIA’s CUDA is al jaren de de-facto standaard: vrijwel elk framework, van PyTorch tot TensorFlow, is primair voor CUDA geoptimaliseerd en nieuwe technieken verschijnen er vrijwel altijd eerst.
AMD’s ROCm heeft flinke stappen gezet en werkt inmiddels redelijk met PyTorch op Linux, maar de ondersteuning blijft achterlopen en de documentatie is dunner. Voor een workstation die gewoon moet werken, zonder gevecht met drivers, is een NVIDIA-GPU in 2026 nog steeds de verstandigste keuze. De meerprijs verdien je terug in bespaarde frustratie.
CPU, moederbord en PCIe-lanes: de fundering
De CPU verzorgt de datavoorbereiding: datasets inladen, voorbewerken en naar de GPU sturen. Bij training met grote datasets kan een trage CPU of trage opslag de GPU laten wachten, waardoor je dure rekenkracht onbenut blijft. Je hebt geen absolute top-CPU nodig, maar bezuinig hier ook weer niet extreem.
Let bij CPU en moederbord vooral op het aantal PCIe-lanes: elke GPU wil het liefst zestien PCIe 4.0- of 5.0-lanes. Consumentenplatforms bieden doorgaans twintig tot achtentwintig lanes — genoeg voor één GPU plus NVMe-schijven, maar krap voor een tweede GPU later. Wie uitbreiding overweegt, kijkt beter naar een HEDT- of workstationplatform. Het moederbord moet vooral degelijk zijn: een robuuste stroomvoorziening, goede VRM-koeling en verstandig geplaatste PCIe-sloten.
Werkgeheugen, opslag en voeding
RAM: 64 GB als uitgangspunt
Voor machine learning is systeemgeheugen bijna net zo belangrijk als VRAM. Grote datasets worden in het werkgeheugen geladen voordat ze batchgewijs naar de GPU gaan, en 32 GB loopt verrassend snel vol. Zie 64 GB DDR5 als het verstandige minimum; wie met zeer grote datasets of meerdere modellen parallel werkt, overweegt 96 of 128 GB. Snelheid en timings zijn hier minder kritisch dan pure capaciteit.
NVMe-opslag: snelheid bij het laden van data
Datasets zijn al snel tientallen tot honderden gigabytes groot, en modelbestanden van tientallen gigabytes zijn geen uitzondering. Een snelle NVMe-SSD van minimaal 2 TB verkort de laadtijden dramatisch, zowel bij het opstarten van training als bij het wisselen tussen modellen. Een tweede schijf voor datasets en checkpoints is een verstandige aanvulling; traditionele harde schijven zijn voor dit werk echt te traag.
Voeding: reken ruim en kies kwaliteit
Een AI-workstation draait urenlang op volle belasting. Tel het maximale verbruik van GPU en CPU bij elkaar op, tel daar zo’n 150 tot 200 watt voor de rest bij, en kies een voeding die daar nog eens twintig tot dertig procent boven zit — voor een zware GPU kom je al snel uit op 1000 watt of meer. Kies 80 Plus Gold of Platinum van een gerenommeerd merk: een instabiele voeding veroorzaakt crashes midden in een training die uren heeft geduurd.
Drie build-voorbeelden: van instap tot high-end
De instap-build is bedoeld om kennis te maken met lokale AI en kleinere modellen te draaien; de middenklasse-build is de sweet spot voor serieuze hobbyisten; de high-end-build is voor wie met grote modellen werkt of lokaal wil finetunen. Prijzen zijn indicaties en kunnen schommelen.
| Component | Instap-build | Middenklasse-build | High-end-build |
|---|---|---|---|
| GPU | GeForce RTX 5070 Ti | GeForce RTX 5080 | GeForce RTX 5090 |
| VRAM | 16 GB GDDR7 | 24 GB GDDR7 | 32 GB GDDR7 |
| CPU | Ryzen 7 9700X | Ryzen 9 9900X | Ryzen 9 9950X |
| Werkgeheugen | 64 GB DDR5 | 96 GB DDR5 | 128 GB DDR5 |
| Opslag | 2 TB NVMe Gen4 | 2 TB NVMe Gen5 | 4 TB NVMe Gen5 |
| Voeding | 850 W Gold | 1000 W Gold | 1200 W Platinum |
| Indicatieprijs | circa 2.200 euro | circa 3.800 euro | circa 6.500 euro |
De instap-build draait comfortabel modellen tot zo’n 13 miljard parameters. De middenklasse-build met 24 GB VRAM is het punt waarop taalmodellen tot 30 miljard parameters soepel draaien, en de high-end-build laat je zelfs met de grootste open modellen werken. Ook de instap-GPU is gekozen met het oog op CUDA-ondersteuning, want dat blijft de doorslaggevende factor.
Koeling en behuizing: onderschat het niet
Een workstation die nachtenlang traint, produceert continu warmte. Investeer in een ruime behuizing met goede airflow en een degelijke CPU-koeler, en zorg dat er geen warme lucht rond de GPU blijft hangen. Houd de temperaturen in de gaten: een thermisch begrensde GPU verliest zomaar tien tot twintig procent prestaties.
Ons eindoordeel
Een goede AI-workstation bouw je van de GPU af naar buiten toe: begin met zoveel VRAM als je budget toelaat, kies voor NVIDIA vanwege het CUDA-ecosysteem, en omring die GPU met voldoende werkgeheugen, snelle NVMe-opslag en een ruim bemeten voeding van topkwaliteit. Voor de meeste gebruikers is de middenklasse-build met 24 GB VRAM en 64 tot 96 GB RAM het verstandigste startpunt.
Met kwantisatietechnieken en efficiëntere architecturen blijft een 24 GB-kaart verrassend lang relevant. Controleer de compatibiliteit van alle onderdelen, en je hebt een krachtpatser onder je bureau die volledig van jou is.