Belangrijkste punten van de redactie
- Chiplets zijn kleine dies die samen één processor vormen; een monolithische chip zet alles op één grote die, waar één defect dodelijk is. Op een chiplet kost het slechts één tegel.
- AMD bouwt EPYC op uit herbruikbare Core Complex Dies (CCD’s) en schaalt zo tot 128 cores per socket, zonder de yield-verliezen van monolithische dies.
- De interconnect is het zenuwstelsel: AMD’s Infinity Fabric verbindt CCD’s via een centrale I/O-die; de open standaard UCIe (3.0, 64 GT/s) maakt chiplets van leveranciers interoperabel.
- Keerzijde: communicatie tussen chiplets is trager en energie-intensiever dan binnen één die. Voor gaming en single-thread-workloads presteert een monolithisch ontwerp soms netter.
- Intel ging van monolithisch naar tiles met Foveros en EMIB; ook NVIDIA stapt over op chiplet-GPU’s. De industrie convergeert naar modulaire packaging.
Chiplets versus monolithische chips: de strijd om de toekomst van de processor
Decennialang was de processor een monolith: één stuk silicium met alle kernen, cache en I/O geïntegreerd. Grotere chips en kleinere nodes braken dat model. De chiplet verdeelt de functionaliteit over kleine dies die via geavanceerde packaging samenwerken als één processor. AMD zette er als eerste groots op in met Zen, Intel volgde met tiles en nu stapt zelfs NVIDIA over.
Wat zijn chiplets — en wat is monolithisch?
Een monolithische chip is één enkele die: alle functionaliteit in één lithografische stap op hetzelfde silicium, begrensd door de reticle limit van circa 858 mm². Kortste signaalpaden, laagste latency, eenvoudigste ontwerp — maar ook de grootste die en het hoogste risico op fabricagefouten.
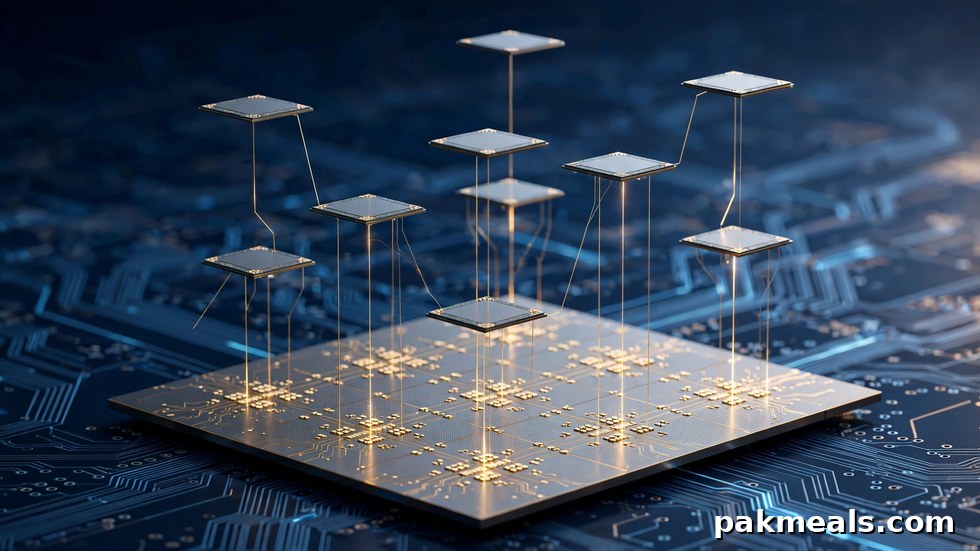
Een chiplet-architectuur splitst die functionaliteit op in kleinere dies — chiplets, of tiles bij Intel — elk geoptimaliseerd voor hun taak: compute-chiplets op een dure node (zoals TSMC 4 nm) naast een I/O-die op een goedkopere, oudere node (zoals 6 nm). Ze worden verbonden via een interconnect op een package-substraat, een silicon interposer of verticaal gestapeld met 3D-packaging — zoals AMD’s EPYC “Turin” (Zen 5): tot zestien CCD’s rond één centrale I/O-die.
De wiskunde van yield: waarom kleinere dies winnen
Het sterkste argument voor chiplets is yield: het percentage werkende chips per wafer. De kans dat een defect een die raakt, groeit met het oppervlak. Op een monolithische die van 660 mm² (zoals Intels oudere Xeon Platinum 8380) maakt één foutje het hele exemplaar waardeloos; op een chiplet van circa 83,7 mm² (een AMD CCD) kost datzelfde defect slechts één tegel.
Meer dies per wafer, hogere yields, lagere kosten per eenheid: AMD produceert een 64-core EPYC naar verluidt goedkoper dan een hypothetische monolithische 16-core chip. Analoge I/O schaalt nauwelijks mee met nieuwe nodes, dus die bouw je goedkoper op een oude node — het dure silicium gaat naar de rekenkernen.
Interconnects: het zenuwstelsel van de chiplet
Chiplets zijn maar zo sterk als hun interconnect: zodra cores over die-grenzen heen communiceren, bepalen bandbreedte, latency en energieverbruik van de verbinding de prestaties.
Infinity Fabric: AMD’s eigen zenuwstelsel
AMD’s Infinity Fabric is de coherente interconnect die sinds Zen CCD’s, I/O-dies en geheugen verbindt. In het hub-and-spoke-model loopt al het verkeer via de centrale I/O-die: schaalbaar en robuust. De prijs is extra hops en latency versus on-die-communicatie. Infinity Fabric is proprietary: alleen AMD-chiplets spreken het vloeiend.
UCIe: de open standaard die leveranciers moet verbinden
Universal Chiplet Interconnect Express (UCIe) is het antwoord op gesloten ecosystemen: een open die-to-die-standaard, in 2022 opgericht door onder meer Intel, AMD, Arm, Google, Meta, Microsoft, Qualcomm, Samsung en TSMC, later versterkt met NVIDIA en Alibaba. UCIe definieert de fysieke laag, protocollen (op PCI Express en CXL) en een software-stack, zodat chiplets van verschillende leveranciers in één package samenwerken.
Na 1.0 (2022) en 1.1 (2023) kwam eind 2025 UCIe 3.0 met 64 GT/s, runtime-recalibratie en 100 mm bereik. Op de Chiplet Summit 2026 toonden Intel en Cadence een live interoperabiliteitstest tussen onafhankelijk ontworpen chiplets — van papier naar silicium, richting een chiplet-marktplaats.
De keerzijde: latency, packaging en complexiteit
Chiplets zijn geen gratis lunch. Ten eerste latency: een signaal over substraat of interposer legt een langere weg af dan binnen één die, met extra hops via een I/O-die. Voor gaming telt elke nanoseconde — Intels eerste desktop-chipletpoging Arrow Lake kampte bij lancering met interconnect-latency.
Ten tweede energie: datatransport tussen dies kost meer vermogen dan on-die-communicatie. Ten derde kosten en complexiteit: geavanceerde packaging (interposers, 3D-stacking, EMIB-bridges) is duur en vereist gespecialiseerde capaciteit zoals TSMC’s CoWoS — een bekende bottleneck. Kleine, latency-kritische chips zoals smartphone-SoC’s blijven daarom voorlopig monolithisch.
Strategie per fabrikant: AMD, Intel en NVIDIA
AMD: chiplet-first sinds Zen
AMD is de pionier en de zuiverste chiplet-speler. Sinds Zen (2017) bouwt het hele portfolio — van Ryzen-desktop tot EPYC-server — op uit herbruikbare CCD’s en I/O-dies. EPYC “Turin” is de meest verfijnde uitvoering: tot zestien CCD’s op TSMC 4 nm rond een I/O-die op 6 nm, goed voor 128 cores per socket. Dezelfde CCD-bouwsteen dient desktop, workstation en server, wat ontwikkelkosten drukt. Met 3D V-Cache stapelt AMD bovendien extra cache verticaal op de CCD.
Intel: van monolithisch naar tiles met Foveros en EMIB
Intel hield het langst vast aan monolithische dies, maar de ommezwaai is compleet. Arrow Lake (Core Ultra 200S) is de eerste chiplet-desktoparchitectuur: aparte Compute-, GPU-, SoC- en I/O-tiles op een Foveros-base-die, met EMIB-bridges voor horizontale verbindingen. Voor AI gaat Intel verder: Ponte Vecchio telde 47 chiplets in één package.
NVIDIA: van monolithisch naar chiplet-GPU’s
NVIDIA bouwde zijn imperium op monolithische dies — de gigantische H100-die is het bekendste voorbeeld. Maar reticle limit en yield-kosten dwingen tot modulariteit: met Blackwell introduceerde NVIDIA een dual-die-ontwerp waarbij twee GPU-dies via een high-bandwidth interconnect als één GPU opereren. Dezelfde yield-wiskunde wint nu ook in AI-accelerators.
Chiplet vs monolithisch: directe vergelijking
| Eigenschap | Chiplet / tiles | Monolithisch |
|---|---|---|
| Yield bij grote chips | Hoog: defect kost één tegel | Laag: één defect is fataal |
| Kosten per werkende chip | Lager door node-mix | Hoger bij grote dies |
| Latency binnen de chip | Hoger door extra hops | Laagst: alles on-die |
| Schaalbaarheid core-count | Uitstekend: identieke dies stapelen | Beperkt door reticle limit (~858 mm²) |
| Procesflexibiliteit | Elke chiplet op zijn optimale node | Alles op één (dure) node |
| Packaging-complexiteit | Hoog: interposers, 3D-stacking, CoWoS | Laag: standaard packaging volstaat |
| Energie voor datatransport | Hoger tussen dies | Lager on-die |
| Interoperabiliteit | Groeiend via UCIe | Niet van toepassing |
Oordeel: praktisch koopadvies
Voor de koper telt wat de architectuur oplevert. Zoek je een server- of workstation-CPU met veel cores, dan is het chiplet-model de enige realistische optie: alleen zo zijn 64 tot 128 cores betaalbaar te produceren. Let wel op NUMA-topologie en geheugenbandbreedte per CCD — daar zit de keerzijde van de modulariteit.
Voor gaming en lichte desktops is het genuanceerder: single-thread-prestaties en lage latency tellen het zwaarst. Een strak monolithisch ontwerp — of een chiplet-ontwerp met 3D V-Cache zoals AMD’s X3D-modellen — verslaat een slecht gebalanceerde tile-architectuur. Kijk naar benchmarks in jouw workload, niet naar “chiplet” als kwaliteitslabel.
Vooruitkijkend maakt UCIe chiplets tot een commodity: binnen enkele jaren vind je packages met een CPU-chiplet van leverancier A en een NPU-chiplet van leverancier B. Voor consumenten betekent dat betere prijs-prestatie, want de yield-wiskunde bevoordeelt kleine dies. De monolithische reus is niet dood, maar zijn dagen als default zijn geteld.